为什么做 WeiboFish?
在政务社交媒体研究中,大量研究最终停留在回归结果、统计表格和静态结论上。即使我们能够发现“什么样的内容更容易产生互动”,这些研究结论仍然很难被直接观察、比较和实际使用。
因此,我尝试把已有的政务微博数据、自然语言处理指标和实证模型进一步转化为一个可交互系统。
WeiboFish 的目标并不是准确预测舆情,而是提供一个发布前的实验环境:用户可以输入拟发布文本,观察其语言特征,寻找语义相似的真实案例,并让具有不同属性和态度的虚拟网民进行模拟互动,从而比较不同文本和传播方案可能形成的互动路径。
核心数字
328,544真实政务微博
337认证政务账号
1,000差异化网民 Agent
约1周首个可运行 MVP
How it works / 工作流程
从文本测度到案例检索、智能体推演、舆论场解释与结果研判,形成连续的研究工作流。
- 01
Measure / 文本测度
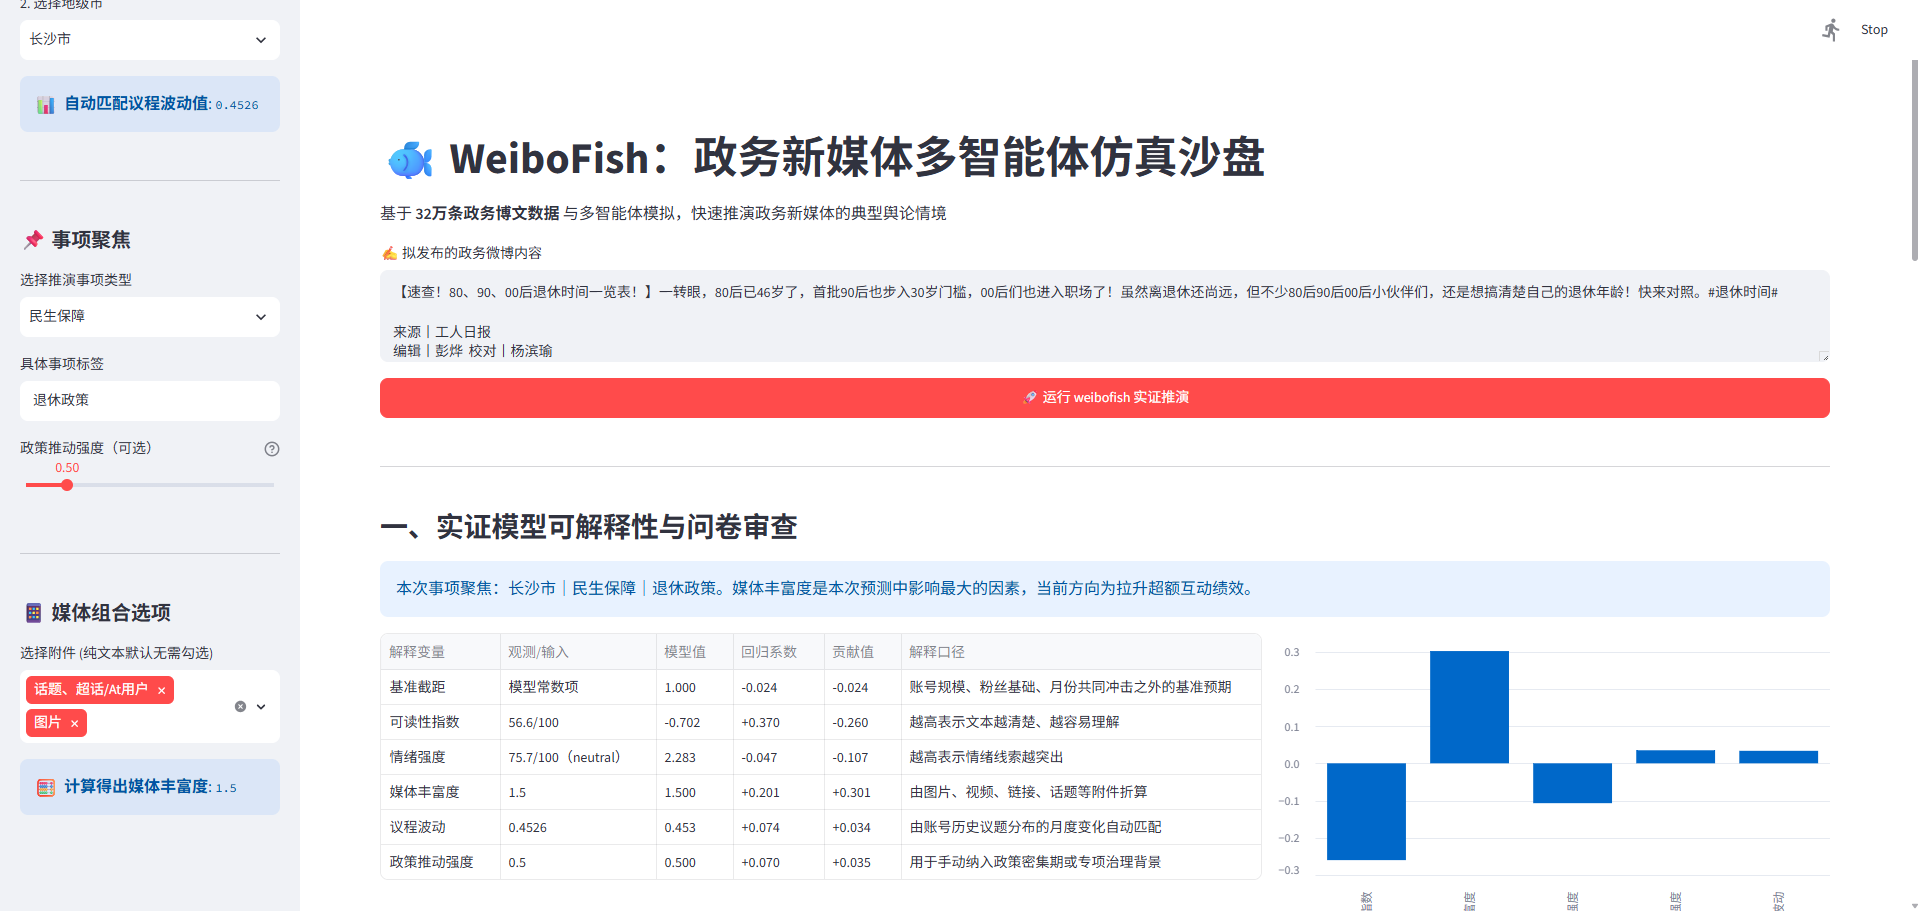
对可读性、情绪强度、媒体丰富度及相关互动因素进行结构化分析。
- 02
Retrieve / 历史案例检索
利用 BGE Embedding + FAISS 检索语义相似的真实政务微博及其互动表现。
- 03
Simulate / 多智能体推演
构建具有差异化属性和态度的虚拟网民,模拟显性互动与后台潜在态度。
- 04
Interpret / 舆论场看板
展示曝光、浏览、点赞、转发、评论、时间动力学与互动网络结构。
- 05
Report / 结果研判
将仿真结果组织为评论区还原与文字化分析,用于方案比较和研究展示。
Product Gallery / 产品界面
截图保留原始界面比例与文字清晰度;点击任一图片可查看完整大图。
From Research to Product / 从研究到产品
WeiboFish 并不是先有产品、再寻找应用场景,而是来源于真实社会科学研究过程。
数据、指标、模型和案例库首先用于回答研究问题,随后才被重新组织为一个可交互原型。
My Role / 我的角色
独立产品负责人 · AI协同实现
Product Design / 产品设计
- 识别政务新媒体运营人员在内容发布前缺少量化反馈与风险预判工具的场景
- 定义产品目标、用户流程和核心功能
- 负责需求拆解、功能设计、迭代方向及最终验收
- 约一周完成首个可运行 MVP,并持续迭代
Research Translation / 研究转化
- 将全国大样本数据、NLP 测量指标与实证参数转化为产品约束
- 设计“文本特征测度 → 历史案例检索 → 多智能体推演 → 舆情诊断 → 研判报告”的完整链路
- 保留研究结果与产品输出之间的可解释关系
- 将学术研究转化为可交互、可测试的研究原型
AI-assisted Implementation / AI协同实现
- 以 Codex 作为主要开发 Agent
- 根据产品需求评估技术方案与实现路径
- 阅读并针对性修改生成代码,定位基础错误
- 协同实现 RAG、语义检索、多智能体仿真与交互功能
- 负责功能测试、迭代与验收
Deployment & Maintenance / 部署维护
- 维护 GitHub 仓库与版本记录
- 配置云服务器、域名与 HTTPS
- 使用 Docker、Linux 与 Nginx 完成部署
- 负责在线版本更新、维护与持续迭代
Methods & Technical Components / 方法与技术组件
Limitations & Responsible Use / 应用边界
WeiboFish 是一个实验性研究原型。真实社会媒体传播受到平台算法、突发事件、账号信誉、用户网络和宏观社会情绪等大量不可观测因素影响。
模拟结果不应被解释为对真实舆论的确定性预测。平台适合用于发布前辅助决策、方案比较、研究展示与教学实验,不能替代专业舆情监测或正式决策过程。Related Research / 相关研究
政府表达与公众互动:来自32.85万条政务微博的证据
WeiboFish 的数据、指标与历史案例库来自这项政务新媒体实证研究。
09 / Case Study
Explore WeiboFish
体验在线原型,或在 GitHub 查看项目代码与版本记录。